
OCR ng PDF – Na-scan na PDF sa Teksto
Kilalanin ang teksto sa mga na-scan na PDF at larawan, saka kopyahin ito o i-save bilang nahahanap na PDF – libre, at hindi umaalis ang file sa iyong aparato.
Magdagdag ng na-scan na PDF o mga larawan (JPG, PNG, WebP)
Sa ngayon, para lang sa mga wikang gumagamit ng Latin na alpabeto ang nahahanap na PDF. Magagamit pa rin ang nakilalang teksto sa itaas.
Sa unang paggamit, dina-download sa iyong browser ang OCR engine (Tesseract) at ang data ng wika mula sa isang pampublikong CDN; hindi kailanman ina-upload ang iyong file.
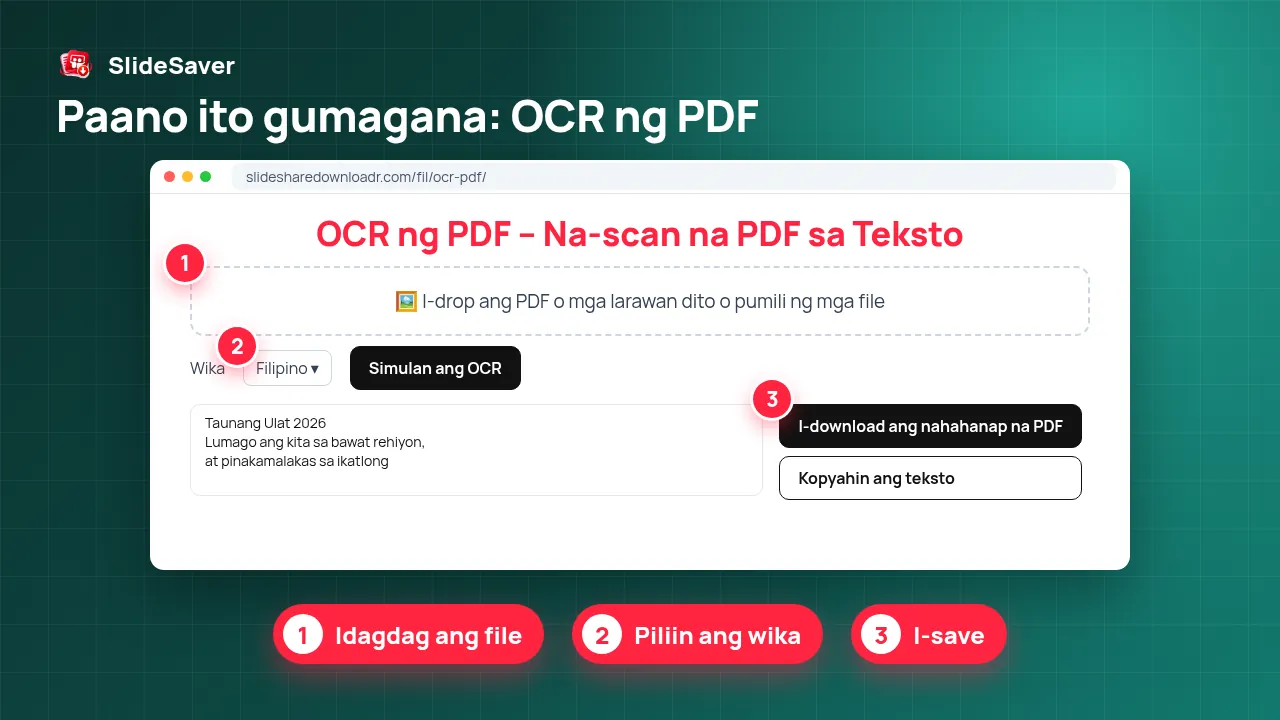
Paano ito gumagana
- Hakbang 1
Idagdag ang file
I-drop ang na-scan na PDF o isa o higit pang larawan.
- Hakbang 2
Piliin ang wika
Piliin ang wika ng dokumento.
- Hakbang 3
Patakbuhin ang OCR
Nire-render at binabasa ang mga pahina sa iyong aparato gamit ang Tesseract.
- Hakbang 4
I-save
Kopyahin ang teksto, i-download bilang .txt o .md, o kunin ang nahahanap na PDF.
Bakit gamitin ang tool na ito
Pribado
Tumatakbo ang OCR sa iyong browser – hindi ina-upload ang dokumento.
Nahahanap na PDF
Nagdadagdag ng di-nakikitang text layer para mahanap at mapili ang teksto.
Libre
Walang account, walang watermark, walang quota sa pahina.
Gawing nahahanap ang na-scan na PDF – libre, sa iyong browser
Ang na-scan na PDF ay talagang patong-patong na larawan: nababasa mo ito, pero hindi ka makapaghanap, makapili o makakopya ng mga salita. Sinusuri ng OCR (optical character recognition) ang bawat larawan ng pahina at inaalam ang teksto. Nire-render ng tool na ito ang bawat pahina gamit ang pdf.js at binabasa gamit ang Tesseract, ang open-source na OCR engine, na tumatakbo sa loob ng iyong browser sa pamamagitan ng WebAssembly.
Makukuha mo ang nakilalang teksto para kopyahin o i-download bilang .txt o Markdown, at para sa mga wikang Latin ang alpabeto, isang nahahanap na PDF na nagpapanatili ng orihinal na mga larawan na may di-nakikitang text layer sa ibabaw – kaya gumagana ang Ctrl+F at copy-paste.
Mainam para sa mga PDF mula sa SlideShare at Scribd na puro larawan
Walang teksto ang mga PDF na ginawa mula sa mga larawan ng slide – gaya ng mga export mula sa aming SlideShare downloader. Ipadaan ang mga ito sa OCR para mahanap o magawang notes, at pagkatapos ay gamitin ang PDF sa Markdown sa nahahanap na PDF o ayusin ang teksto gamit ang Markdown sa PDF.
Makatotohanang inaasahan
Walang OCR na 100% tumpak. Kadalasang napakaganda ng resulta sa malinis at malinaw na scan ng nakalimbag na teksto; mas maraming mali sa sulat-kamay, malabong litrato, magarbong font, table at magkahalong wika. Laging suriin ang mga pangalan, numero at petsa. Matagal ang malalaking dokumento dahil sa iyong aparato ginagawa ang lahat – subukan muna ang ilang pahina gamit ang field na “Mga pahina”.
FAQ
Ina-upload ba ang aking PDF?
Hindi. Nire-render at kinikilala ang mga pahina sa iyong browser. Ang OCR engine at data ng wika lang ang dina-download mula sa pampublikong CDN.
Gaano katumpak ang OCR?
Maganda sa malinaw na nakalimbag na teksto, at mas mahina sa sulat-kamay, malabong litrato, maliliit na font at komplikadong layout. Laging suriin ang resulta.
Anong mga wika ang suportado?
18 wika, kabilang ang Filipino, Ingles, Espanyol, Pranses, Aleman, Portuges, Indonesian, Ruso, Arabe, Hindi, Urdu, Chinese, Japanese at Korean. Magagamit ang nahahanap na PDF para sa mga wikang Latin ang alpabeto.
Gaano ito katagal?
Karaniwang ilang segundo bawat pahina sa modernong computer; mas matagal sa telepono. Sa unang paggamit, dina-download din ang engine at data ng wika.
Gumagana ba ito sa mga PDF mula sa SlideShare o Scribd na puro larawan?
Oo. Iyan mismo ang silbi ng OCR.
May limitasyon ba sa pahina?
Walang takdang limitasyon, pero malaki ang memory na nagagamit ng napakalalaking file. Gamitin ang field na “Mga pahina” para sa malalaking dokumento.