
OCR de PDF – de PDF digitalizado para texto
Reconheça o texto de PDFs digitalizados e imagens e copie-o ou salve um PDF pesquisável – grátis, e seu arquivo nunca sai do seu dispositivo.
Adicione um PDF digitalizado ou imagens (JPG, PNG, WebP)
Por enquanto, o PDF pesquisável só está disponível para idiomas de alfabeto latino. O texto reconhecido acima continua disponível.
O motor de OCR (Tesseract) e os dados do idioma são baixados para o navegador a partir de uma CDN pública na primeira vez; seu arquivo nunca é enviado.
Como funciona
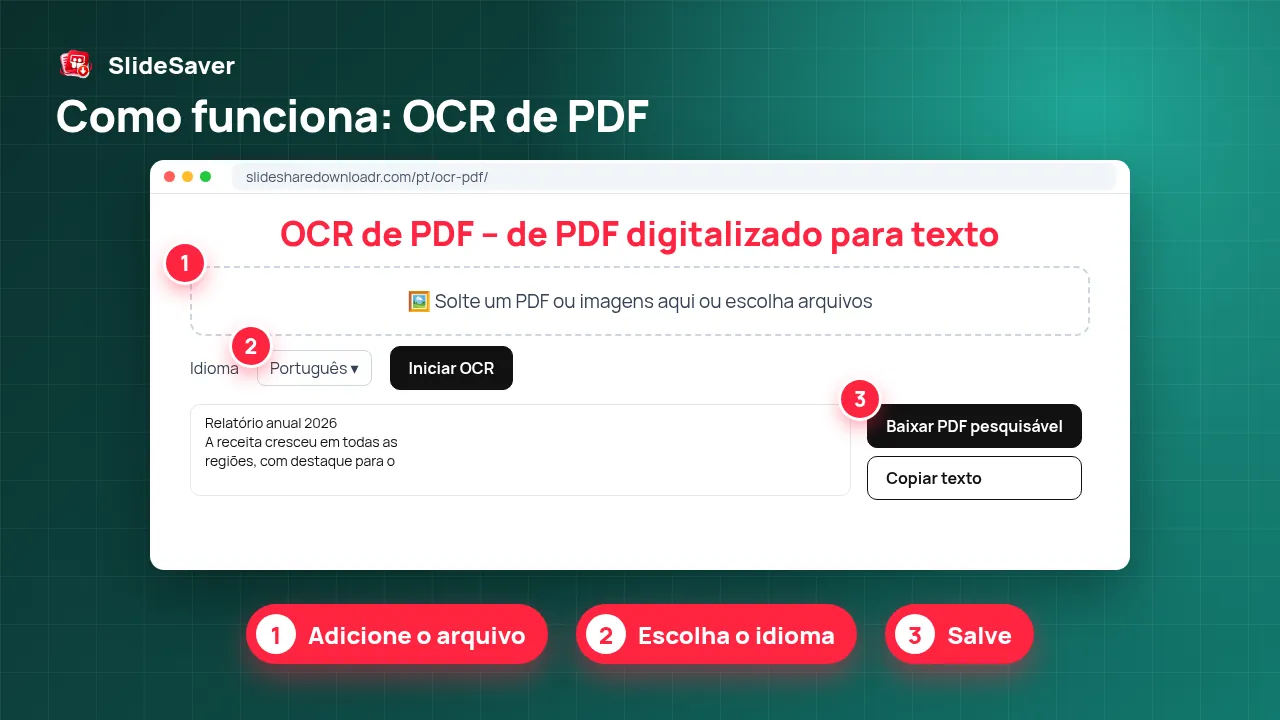
- Passo 1
Adicione o arquivo
Solte um PDF digitalizado ou uma ou mais imagens.
- Passo 2
Escolha o idioma
Selecione o idioma do documento.
- Passo 3
Execute o OCR
As páginas são renderizadas e lidas no seu dispositivo com o Tesseract.
- Passo 4
Salve
Copie o texto, baixe em .txt ou .md ou obtenha um PDF pesquisável.
Por que usar esta ferramenta
Privado
O OCR roda no navegador – o documento não é enviado.
PDF pesquisável
Adiciona uma camada de texto invisível para pesquisar e selecionar o texto.
Grátis
Sem conta, sem marca d’água e sem cota de páginas.
Torne um PDF digitalizado pesquisável – grátis, no navegador
Um PDF digitalizado é, na verdade, uma pilha de imagens: dá para ler, mas não para pesquisar, selecionar ou copiar palavras. O OCR (reconhecimento óptico de caracteres) analisa cada imagem de página e extrai o texto. Esta ferramenta renderiza cada página com o pdf.js e a lê com o Tesseract, o motor de OCR de código aberto, que roda dentro do navegador via WebAssembly.
Você recebe o texto reconhecido para copiar ou baixar como .txt ou Markdown e, em idiomas de alfabeto latino, um PDF pesquisável que mantém as imagens originais com uma camada de texto invisível por cima – assim Ctrl+F e copiar e colar funcionam.
Ideal para PDFs do SlideShare e do Scribd feitos de imagens
PDFs criados a partir de imagens de slides – como as exportações do nosso downloader do SlideShare – não contêm texto. Passe-os pelo OCR para pesquisar neles ou transformá-los em anotações e, depois, use PDF para Markdown no PDF pesquisável ou formate o texto com Markdown para PDF.
Expectativas realistas
Nenhum OCR é 100% preciso. Digitalizações limpas e com bom contraste de texto impresso costumam sair muito bem; letra cursiva, fotos tremidas, fontes decorativas, tabelas e idiomas misturados geram mais erros. Sempre confira nomes, números e datas. Documentos grandes demoram porque todo o trabalho é feito no seu dispositivo – teste antes algumas páginas com o campo “Páginas”.
FAQ
Meu PDF é enviado?
Não. As páginas são renderizadas e reconhecidas no navegador. Só o motor de OCR e os dados do idioma são baixados de uma CDN pública.
Qual é a precisão do OCR?
Boa em texto impresso nítido e menor em letra cursiva, fotos tremidas, letras pequenas e layouts complexos. Sempre revise o resultado.
Quais idiomas são aceitos?
18 idiomas, incluindo português, inglês, espanhol, francês, alemão, indonésio, filipino, russo, árabe, hindi, urdu, chinês, japonês e coreano. O PDF pesquisável está disponível para idiomas de alfabeto latino.
Quanto tempo leva?
Normalmente alguns segundos por página num computador moderno; mais no celular. Na primeira vez, o motor e os dados do idioma também são baixados.
Funciona com PDFs do SlideShare ou do Scribd feitos de imagens?
Sim. É exatamente para isso que o OCR serve.
Existe limite de páginas?
Não há limite fixo, mas arquivos muito grandes usam bastante memória. Use o campo “Páginas” em documentos grandes.