
OCR de PDF – de PDF escaneado a texto
Reconoce el texto de PDF escaneados e imágenes y cópialo o guárdalo como PDF buscable: gratis, y tu archivo nunca sale de tu dispositivo.
Añade un PDF escaneado o imágenes (JPG, PNG, WebP)
Por ahora el PDF buscable solo está disponible para idiomas con alfabeto latino. El texto reconocido de arriba sigue disponible.
El motor de OCR (Tesseract) y los datos del idioma se descargan a tu navegador desde una CDN pública la primera vez; tu archivo nunca se sube.
Cómo funciona
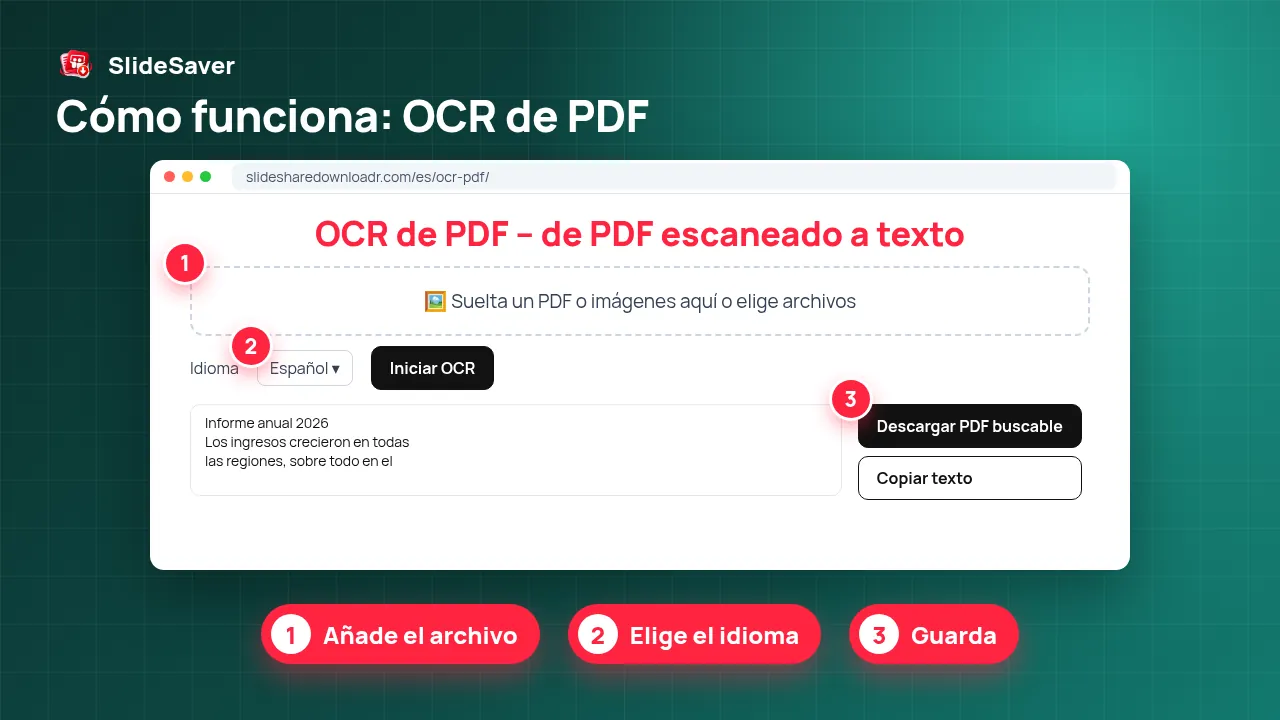
- Paso 1
Añade el archivo
Suelta un PDF escaneado o una o varias imágenes.
- Paso 2
Elige el idioma
Selecciona el idioma del documento.
- Paso 3
Ejecuta el OCR
Las páginas se procesan y se leen en tu dispositivo con Tesseract.
- Paso 4
Guarda
Copia el texto, descárgalo en .txt o .md o baja un PDF buscable.
Por qué usar esta herramienta
Privado
El OCR se ejecuta en tu navegador: el documento no se sube.
PDF buscable
Añade una capa de texto invisible para buscar y seleccionar texto.
Gratis
Sin cuenta, sin marca de agua y sin cupo de páginas.
Haz buscable un PDF escaneado, gratis y en tu navegador
Un PDF escaneado es en realidad una pila de imágenes: puedes leerlo, pero no buscar, seleccionar ni copiar palabras. El OCR (reconocimiento óptico de caracteres) analiza cada imagen de página y obtiene el texto. Esta herramienta procesa cada página con pdf.js y la lee con Tesseract, el motor de OCR de código abierto, que funciona dentro de tu navegador mediante WebAssembly.
Obtienes el texto reconocido para copiarlo o descargarlo como .txt o Markdown y, en idiomas con alfabeto latino, un PDF buscable que conserva las imágenes originales con una capa de texto invisible encima, para que funcionen Ctrl+F y copiar y pegar.
Ideal para PDF de SlideShare y Scribd hechos de imágenes
Los PDF creados a partir de imágenes de diapositivas, como las exportaciones de nuestro descargador de SlideShare, no contienen texto. Pásalos por el OCR para poder buscar en ellos o convertirlos en apuntes; después puedes usar PDF a Markdown con el PDF buscable o maquetar el texto con Markdown a PDF.
Expectativas realistas
Ningún OCR es 100 % preciso. Los escaneos limpios y con buen contraste de texto impreso suelen salir muy bien; la letra manuscrita, las fotos borrosas, las fuentes decorativas, las tablas y la mezcla de idiomas generan más errores. Revisa siempre nombres, cifras y fechas. Los documentos grandes tardan porque todo el trabajo se hace en tu dispositivo: prueba antes unas pocas páginas con el campo «Páginas».
FAQ
¿Se sube mi PDF?
No. Las páginas se procesan y reconocen en tu navegador. Solo se descargan el motor de OCR y los datos del idioma desde una CDN pública.
¿Qué precisión tiene el OCR?
Buena con texto impreso limpio y peor con letra manuscrita, fotos borrosas, letra pequeña y diseños complejos. Revisa siempre el resultado.
¿Qué idiomas admite?
18 idiomas, entre ellos español, inglés, francés, alemán, portugués, indonesio, filipino, ruso, árabe, hindi, urdu, chino, japonés y coreano. El PDF buscable está disponible para idiomas con alfabeto latino.
¿Cuánto tarda?
Normalmente unos segundos por página en un ordenador moderno; más en móviles. La primera vez también se descargan el motor y los datos del idioma.
¿Funciona con PDF de SlideShare o Scribd hechos de imágenes?
Sí. Para eso precisamente sirve el OCR.
¿Hay límite de páginas?
No hay un límite fijo, pero los archivos muy grandes usan mucha memoria. Usa el campo «Páginas» en documentos grandes.