
OCR PDF – PDF Hasil Pindai ke Teks
Kenali teks dari PDF hasil pindai dan gambar, lalu salin atau simpan sebagai PDF yang bisa dicari – gratis, dan file Anda tidak pernah keluar dari perangkat.
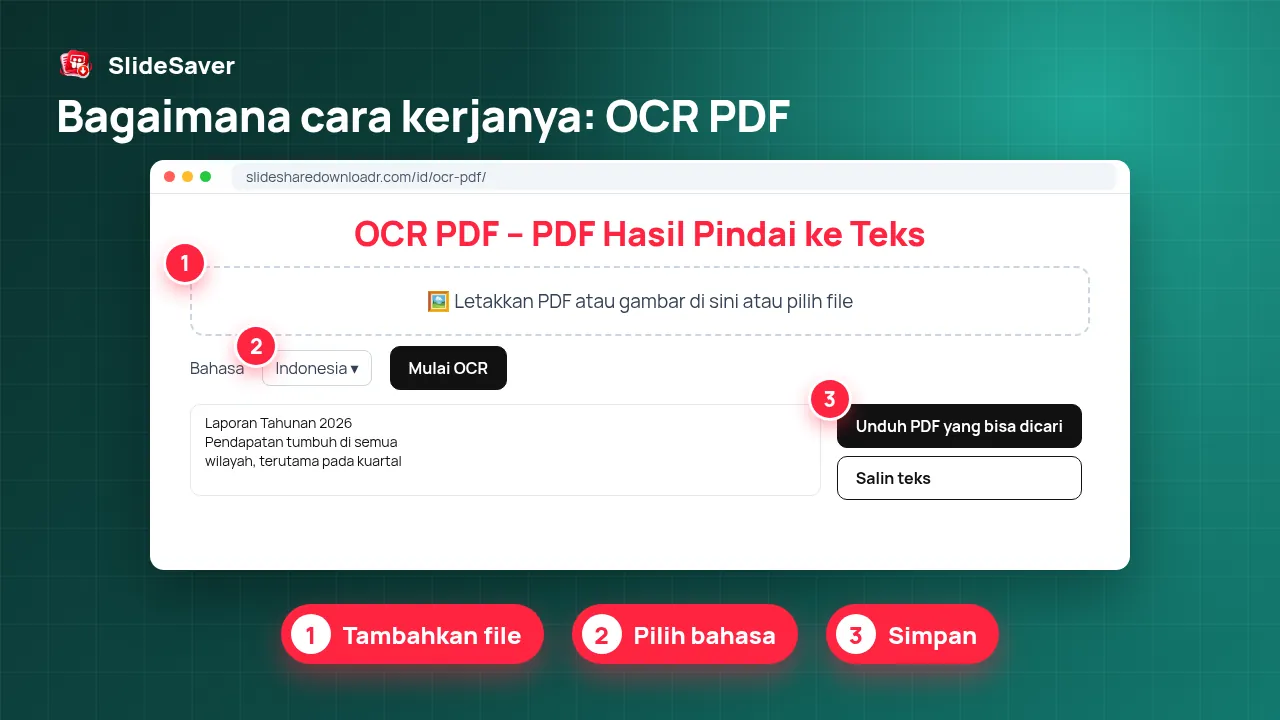
Tambahkan PDF hasil pindai atau gambar (JPG, PNG, WebP)
Untuk saat ini PDF yang bisa dicari hanya tersedia untuk bahasa beraksara Latin. Teks yang dikenali di atas tetap tersedia.
Mesin OCR (Tesseract) dan data bahasa diunduh ke browser Anda dari CDN publik saat pertama kali dipakai; file Anda tidak pernah diunggah.
Bagaimana cara kerjanya
- Langkah 1
Tambahkan file
Letakkan PDF hasil pindai atau satu atau beberapa gambar.
- Langkah 2
Pilih bahasa
Pilih bahasa dokumen.
- Langkah 3
Jalankan OCR
Halaman dirender dan dibaca di perangkat Anda dengan Tesseract.
- Langkah 4
Simpan
Salin teks, unduh sebagai .txt atau .md, atau dapatkan PDF yang bisa dicari.
Mengapa menggunakan alat ini
Privat
OCR berjalan di browser Anda – dokumen tidak diunggah.
PDF yang bisa dicari
Menambahkan lapisan teks tak terlihat agar teks bisa dicari dan dipilih.
Gratis
Tanpa akun, tanpa watermark, tanpa kuota halaman.
Jadikan PDF hasil pindai bisa dicari – gratis, di browser Anda
PDF hasil pindai sebenarnya hanyalah tumpukan gambar: Anda bisa membacanya, tetapi tidak bisa mencari, memilih, atau menyalin kata. OCR (pengenalan karakter optik) menganalisis setiap gambar halaman dan mengenali teksnya. Alat ini merender setiap halaman dengan pdf.js dan membacanya dengan Tesseract, mesin OCR sumber terbuka, yang berjalan di dalam browser Anda melalui WebAssembly.
Anda mendapatkan teks yang dikenali untuk disalin atau diunduh sebagai .txt atau Markdown, dan untuk bahasa beraksara Latin, PDF yang bisa dicari dengan gambar asli tetap utuh dan lapisan teks tak terlihat di atasnya – sehingga Ctrl+F dan salin-tempel berfungsi.
Cocok untuk PDF SlideShare dan Scribd berupa gambar
PDF yang dibuat dari gambar slide – seperti hasil ekspor pengunduh SlideShare kami – tidak berisi teks. Proses dengan OCR agar bisa dicari atau dijadikan catatan, lalu gunakan PDF ke Markdown pada PDF yang bisa dicari atau tata ulang teksnya dengan Markdown ke PDF.
Harapan yang realistis
Tidak ada OCR yang 100% akurat. Hasil pindai yang bersih dan kontras dari teks cetak biasanya sangat baik; tulisan tangan, foto buram, huruf dekoratif, tabel, dan campuran bahasa menghasilkan lebih banyak kesalahan. Selalu periksa nama, angka, dan tanggal. Dokumen besar butuh waktu karena semua pekerjaan dilakukan di perangkat Anda – coba beberapa halaman dulu dengan kolom “Halaman”.
FAQ
Apakah PDF saya diunggah?
Tidak. Halaman dirender dan dikenali di browser Anda. Hanya mesin OCR dan data bahasa yang diunduh dari CDN publik.
Seberapa akurat OCR-nya?
Baik untuk teks cetak yang jelas, kurang baik untuk tulisan tangan, foto buram, huruf kecil, dan tata letak rumit. Selalu periksa hasilnya.
Bahasa apa saja yang didukung?
18 bahasa, termasuk Indonesia, Inggris, Spanyol, Prancis, Jerman, Portugis, Filipino, Rusia, Arab, Hindi, Urdu, Tionghoa, Jepang, dan Korea. PDF yang bisa dicari tersedia untuk bahasa beraksara Latin.
Berapa lama prosesnya?
Biasanya beberapa detik per halaman di komputer modern; lebih lama di ponsel. Saat pertama kali, mesin dan data bahasa juga diunduh.
Apakah bisa untuk PDF SlideShare atau Scribd berupa gambar?
Bisa. Justru itulah gunanya OCR.
Apakah ada batas halaman?
Tidak ada batas tetap, tetapi file yang sangat besar memakai banyak memori. Gunakan kolom “Halaman” untuk dokumen besar.