A versão rápida
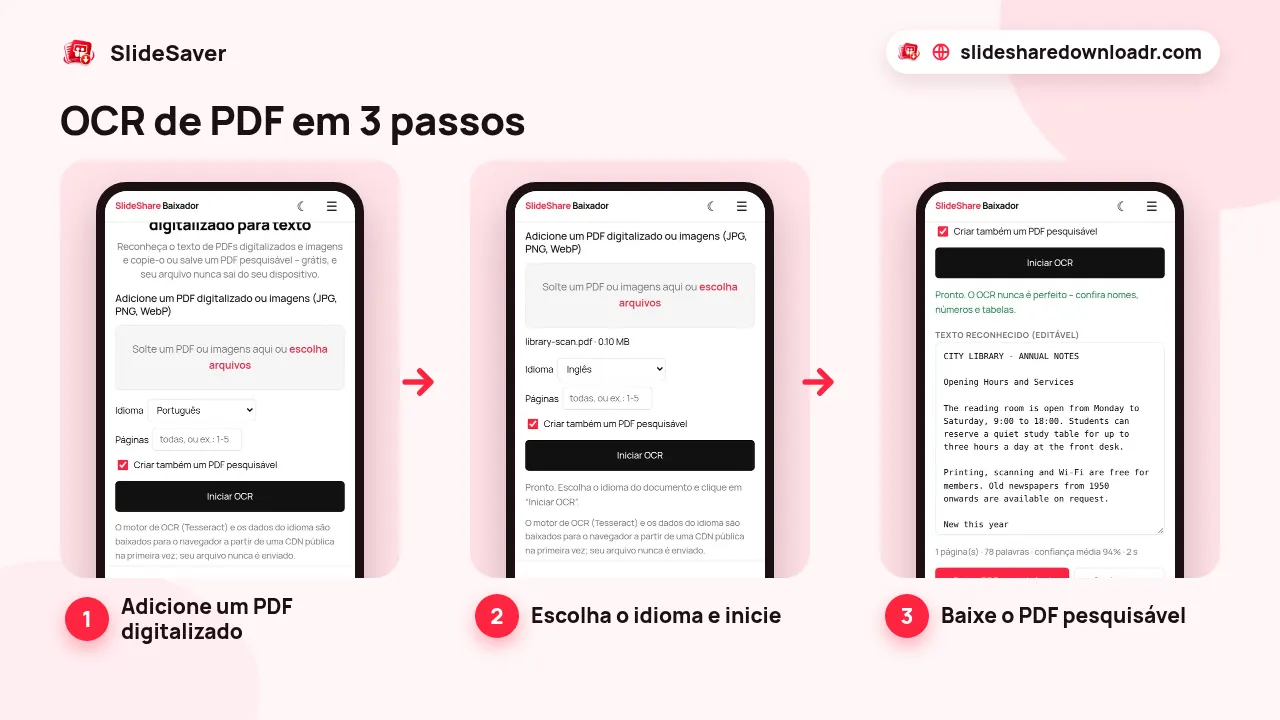
Abra nossa ferramenta gratuita de OCR de PDF, adicione um PDF digitalizado (ou várias imagens JPG, PNG ou WebP), escolha o idioma do documento, deixe marcada a opção Criar também um PDF pesquisável e toque em Iniciar OCR. No fim, toque em Baixar PDF pesquisável, ou copie o texto, ou baixe como .txt ou .md. O reconhecimento acontece no seu aparelho. Só o motor de OCR e os dados de idioma são baixados de uma CDN pública na primeira vez; seu arquivo não é enviado.
Seu PDF precisa de OCR?
Abra o PDF e tente selecionar uma palavra, ou pressione Ctrl+F (Cmd+F no Mac) e procure algo que você está vendo. Se nada for encontrado, as páginas são imagens e você precisa de OCR. Exemplos comuns: digitalizações de escritório, fotos do celular salvas como PDF, livros antigos, faxes e apresentações exportadas como imagens.
Nosso conversor de PDF para Markdown também avisa quando um PDF quase não tem texto.
Passo a passo: como fazer OCR de um PDF grátis
- Adicione o arquivo. A ferramenta aceita um PDF por vez. Se você soltar vários PDFs, só o primeiro é usado. Já imagens você pode adicionar várias de uma vez; elas viram páginas na ordem em que foram escolhidas.
- Escolha o idioma. Há 18 idiomas, entre eles português, inglês, espanhol, francês, alemão, indonésio, filipino, russo, árabe, híndi, urdu, chinês, japonês e coreano. O idioma certo faz muita diferença.
- Opcional: escolha as páginas. Em Páginas, digite
1-5ou1, 3, 8-para testar parte de um PDF longo. Deixe vazio para todas. - Inicie o OCR. Na primeira vez, o motor de código aberto Tesseract e os dados do idioma são baixados e ficam guardados no navegador. Cada página é renderizada em alta resolução e lida no seu aparelho, com uma mensagem de progresso por página. Parar mantém as páginas já concluídas.
- Salve o resultado. Baixe o PDF pesquisável, copie o texto ou baixe .txt ou .md.
O que você recebe: PDF pesquisável e texto
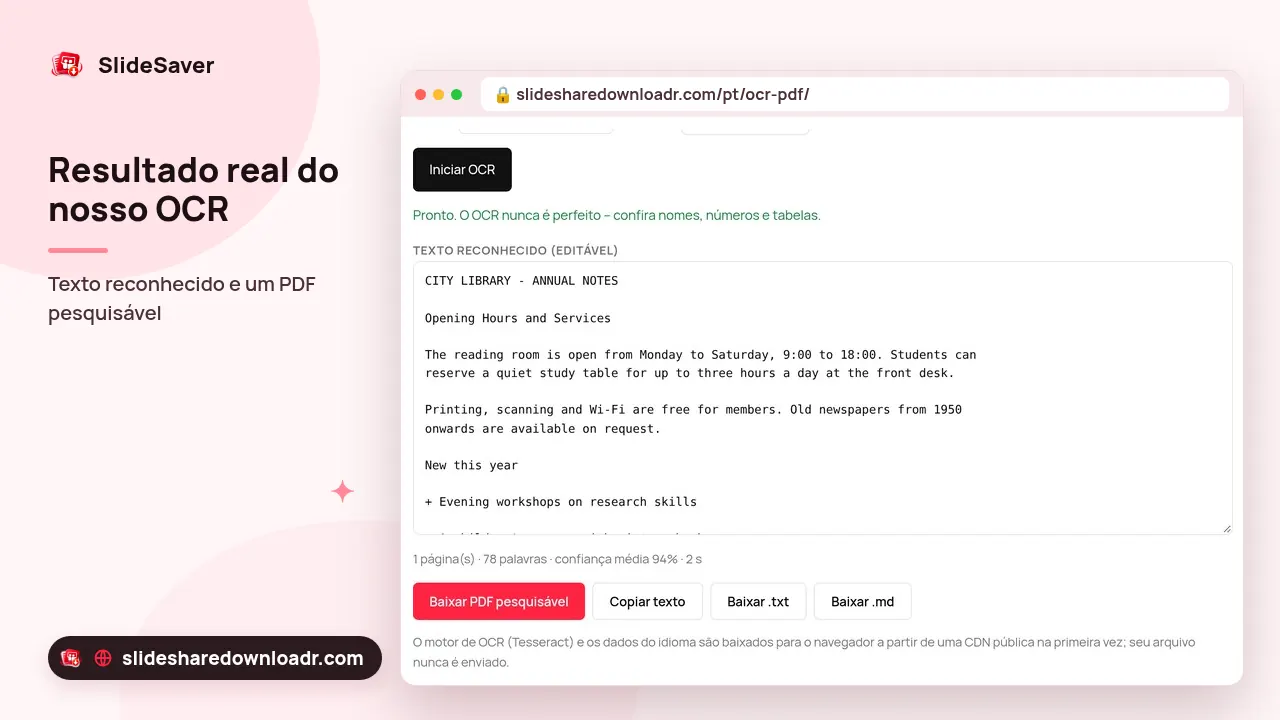
O PDF pesquisável mostra cada página original como imagem, com texto invisível posicionado atrás das palavras. Ele parece igual à digitalização, mas Ctrl+F, selecionar e copiar passam a funcionar, e outros aplicativos conseguem lê-lo. Para manter o arquivo num tamanho razoável, as imagens das páginas são salvas em JPEG com cerca de 1.700 pixels no lado maior, então o resultado pode ficar um pouco mais suave que uma digitalização em altíssima resolução.
- Só idiomas de escrita latina. O PDF pesquisável é criado para inglês, espanhol, francês, alemão, português, italiano, indonésio, holandês, filipino, turco e polonês. Para russo, árabe, híndi, urdu, chinês, japonês e coreano você recebe o texto reconhecido, mas não o PDF pesquisável.
- Letras especiais. A camada oculta guarda caracteres da Europa Ocidental, então letras como o ł polonês ou o ş turco ficam de fora dela. A saída de texto mantém essas letras.
- Saída de texto. As páginas são separadas por uma linha de "página"; o download .md adiciona um título por página.
- Tabelas viram linhas simples. O OCR lê tabelas linha por linha; as colunas não são reconstruídas.
Qual é a precisão de um OCR grátis?
Numa digitalização limpa e reta de texto impresso, o Tesseract acerta a maioria das palavras. Depois de cada execução, a ferramenta mostra uma confiança média e avisa quando ela está baixa. A precisão cai com:
- letra de mão (o motor foi feito para texto impresso)
- fotos borradas, tortas ou de baixa resolução
- fontes muito pequenas ou decorativas
- tabelas complexas, formulários e layouts com várias colunas
- idiomas misturados ou o idioma errado selecionado
Sempre confira nomes, números e datas antes de confiar neles. Nenhum OCR é perfeito, nem os pagos.
Dicas para resultados melhores
- Digitalize a 300 dpi em preto e branco ou tons de cinza, se puder.
- Fotografe as páginas planas, com boa luz e a câmera paralela à folha.
- Corte bordas escuras e dedos antes de transformar as fotos em PDF.
- Escolha o idioma do documento, não o do site.
- Teste algumas páginas primeiro e depois o arquivo inteiro. Arquivos grandes demoram: conte alguns segundos por página num notebook e mais num celular.
O que fazer depois
Quer perguntar algo a uma IA sobre o documento? Converta o PDF pesquisável com PDF para Markdown; nosso guia para converter PDF para Markdown para o ChatGPT mostra como. Para transformar o texto revisado num material caprichado, use Markdown para PDF.
Apresentações salvas com SlideShare para PDF ou pelo Scribd Downloader muitas vezes são só imagens, e o OCR também as deixa pesquisáveis. Se antes você precisa de uma apresentação pública, dá para baixar apresentações do SlideShare de graça em poucos cliques. Use só conteúdo que você tem permissão para usar e dê crédito ao autor.
FAQ
Este OCR é mesmo grátis?
Sim. Sem conta, sem marca d'água e sem limite de páginas.
Posso fazer OCR de vários PDFs de uma vez?
Não. A ferramenta lê um PDF por execução. Mas você pode adicionar várias imagens de uma vez.
Por que não há PDF pesquisável para o meu idioma?
O PDF pesquisável só funciona com idiomas de escrita latina. Para russo, árabe, híndi, urdu, chinês, japonês e coreano, você ainda pode copiar o texto ou baixá-lo como .txt ou .md.
Meu PDF digitalizado é enviado para algum servidor?
Não. O OCR roda no seu aparelho. Só o motor e os dados de idioma são baixados na primeira vez.
Ele lê letra de mão ou mantém tabelas?
Ele foi feito para texto impresso, então letra de mão não é confiável. As tabelas saem como linhas de texto.