
Конвертер PDF в Markdown
Превратите PDF в аккуратный Markdown с заголовками, списками и абзацами – бесплатно, а файл никогда не покидает ваше устройство.
Добавьте PDF для конвертации в Markdown (.md)
Сканированный PDF? Откройте OCR для PDF, чтобы прочитать текст с изображений страниц.
Как это работает
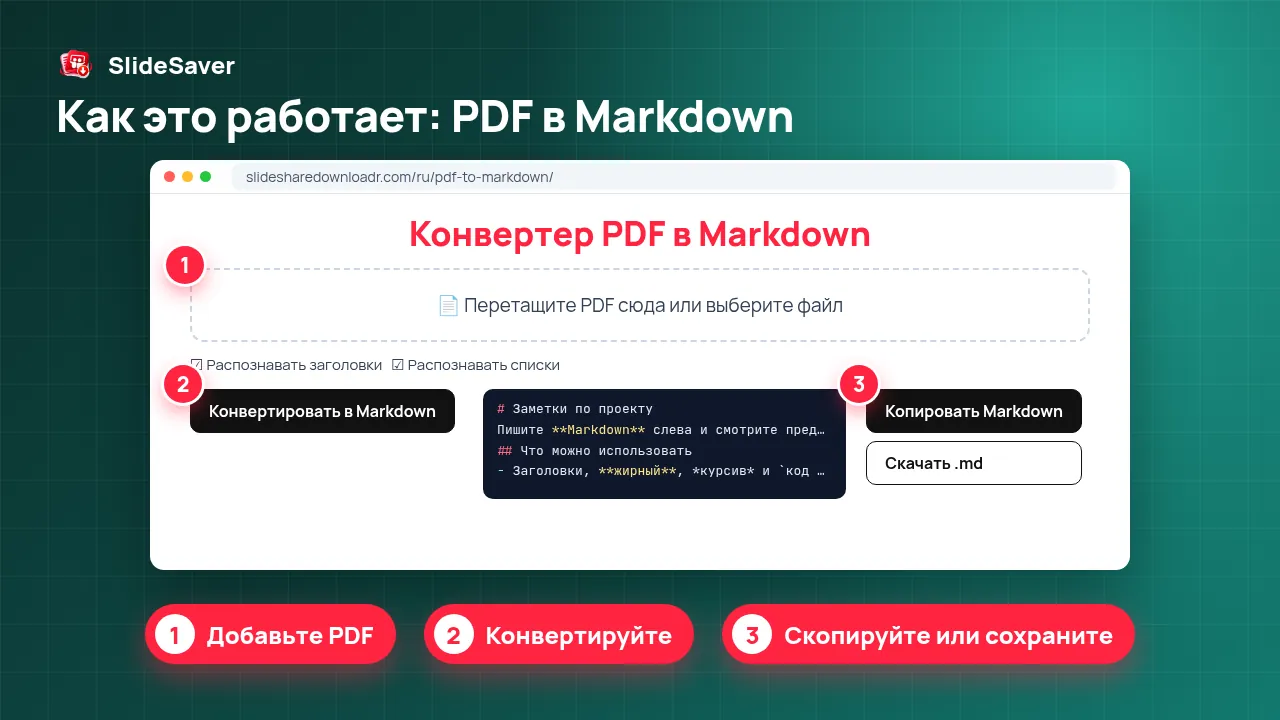
- Шаг 1
Добавьте PDF
Перетащите PDF или выберите его на устройстве.
- Шаг 2
Выберите параметры
Заголовки, списки и очистка колонтитулов включены по умолчанию.
- Шаг 3
Конвертируйте
Текст читается и структурируется локально с помощью pdf.js.
- Шаг 4
Скопируйте или сохраните
Скопируйте Markdown или скачайте его в формате .md или JSON.
Зачем использовать этот инструмент
Конфиденциально
PDF обрабатывается в вашем браузере и никогда не загружается.
Готово для ИИ
Markdown сохраняет структуру, поэтому ChatGPT и другие ИИ понимают его лучше, чем простой текст.
Бесплатно
Без аккаунта и водяных знаков, а число страниц ограничено только памятью устройства.
Конвертируйте PDF в MD для ChatGPT, Notion и Obsidian
Markdown – это обычный текст с лёгкой разметкой: # для заголовков, - для пунктов списка и пустые строки между абзацами. Он сохраняет структуру без вёрсточного «шума» PDF, поэтому это самый удобный формат, чтобы вставить текст в ChatGPT, Claude или Gemini, импортировать в Notion или Obsidian либо хранить рядом с кодом на GitHub.
Этот конвертер читает текстовый слой PDF с помощью PDF.js от Mozilla и восстанавливает структуру: крупные строки становятся заголовками, маркеры и нумерованные строки – списками, разорванные строки склеиваются в абзацы, а слова с переносами восстанавливаются. Номера страниц и колонтитулы, повторяющиеся на каждой странице, можно убрать.
Что получается хорошо, а что нет
Отчёты, статьи, электронные книги, методички и большинство презентаций в PDF конвертируются хорошо. Многоколоночная вёрстка, таблицы и формулы могут потребовать небольшой правки: таблицы выводятся строками текста, а не таблицами Markdown. У сканированных PDF и файлов, состоящих только из изображений (частый случай при скачивании со SlideShare и Scribd), нет текстового слоя – сначала обработайте их в OCR для PDF. Нужно наоборот? Воспользуйтесь Markdown в PDF.
FAQ
Мой PDF загружается на сервер?
Нет. Конвертация полностью выполняется в браузере с помощью JavaScript. Файл не отправляется на наш сервер.
Сохраняются ли заголовки и списки?
Да. Заголовки определяются по размеру шрифта, а маркированные и нумерованные строки превращаются в списки Markdown. Результат зависит от того, как был создан PDF, поэтому стоит быстро его просмотреть.
Почему результат пустой?
Скорее всего, PDF отсканирован или состоит из изображений, и в нём нет выделяемого текста. Сначала воспользуйтесь нашим бесплатным OCR для PDF.
Можно ли конвертировать PDF в JSON?
Да. Нажмите «Скачать JSON», чтобы получить то же содержимое в виде структурированных блоков (заголовки, абзацы, списки) по страницам.
Конвертируются ли таблицы?
Таблицы выводятся строками текста. Возможно, их придётся вручную оформить как таблицы Markdown.
А PDF с паролем?
Зашифрованные PDF прочитать нельзя. Сначала снимите защиту с помощью полученного пароля.